SAP-RPT : comment exploiter l’IA prédictive dans vos environnements SAP sans entraîner de modèle ?
Prédire un retard de paiement, affecter une facture au bon compte ou estimer un risque de rupture de stock nécessite traditionnellement de préparer les données, d’entraîner un modèle de machine learning, puis de le déployer et de le maintenir. Avec SAP-RPT, SAP propose une autre approche : un modèle préentraîné capable de produire des prédictions à partir d’exemples fournis au moment de la requête.
Annoncé fin 2025, SAP-RPT-1 a évolué vers RPT-1.5 en 2026 (model card publiée en juillet), puis vers RPT-1.6, accompagné d’un service d’orchestration, le 7 septembre. À SAP TechEd 2026, SAP a fait du modèle une famille : RPT-TS pour les séries temporelles, RPT-Decisions pour les décisions dans les processus, RPT-2 pour la détection d’anomalies et le multi-tables.
Ce qu’il faut retenir
- SAP-RPT simplifie l’accès à l’IA prédictive dans les environnements SAP. Ce modèle préentraîné permet de réaliser des prédictions sur des données structurées sans entraîner de modèle spécifique à chaque cas d’usage.
- Les applications métier sont concrètes. Affectation comptable, prévision de la demande, classification de données et automatisation de certaines décisions peuvent bénéficier de cette approche.
- SAP TechEd 2026 élargit les possibilités. Avec RPT-TS, RPT-Decisions et RPT-2, SAP étend progressivement l’IA tabulaire aux séries temporelles, aux décisions métier et à l’analyse de données issues de plusieurs tables.
- SAP-RPT ne remplace pas systématiquement le machine learning classique. La précision, les performances, les coûts et les contraintes d’intégration doivent être évalués selon chaque cas d’usage.
- La gouvernance des prédictions devient un enjeu majeur pour les DSI. Qualité des données, validation des résultats, explicabilité et contrôle humain restent indispensables pour intégrer ces capacités aux processus SAP.
Comment SAP-RPT simplifie-t-il les prédictions à partir de vos données métier ?
RPT signifie Relational Pretrained Transformer. Ce modèle est spécialisé dans les données structurées : il ne s’agit pas d’un grand modèle de langage généraliste. Son architecture mobilise des mécanismes d’attention bidimensionnelle et des représentations sémantiques des données, principes présentés dans les travaux ConTextTab publiés à NeurIPS 2025.
Concrètement, le modèle lit un tableau comme le ferait un comptable expérimenté devant un lot de factures. Il examine chaque ligne en la comparant aux lignes voisines, et il tient compte de ce que représente chaque colonne (un montant, un fournisseur, un libellé) plutôt que de traiter des valeurs anonymes : c’est l’attention « dans les deux sens », par ligne et par colonne. Et parce qu’il comprend le sens des intitulés et des textes, un libellé comme « maintenance chaudière » le rapproche d’un compte de charges d’entretien même s’il ne l’a jamais rencontré sous cette forme exacte, là où un algorithme classique n’y verrait qu’un code parmi d’autres : ce sont les représentations sémantiques.
Son principe est l’apprentissage en contexte tabulaire (tabular in-context learning). Pour automatiser l’affectation des comptes comptables, une entreprise transmet, par exemple, plusieurs centaines de factures historiques avec leurs comptes renseignés, puis les nouvelles factures dont le compte doit être prédit. Les lignes historiques constituent le contexte ; les nouvelles lignes constituent les requêtes.
Le modèle prédit directement, sans entraînement ni fine-tuning propres à ce cas d’usage. Il est néanmoins préentraîné : « sans apprentissage préalable » serait donc inexact. La sélection d’exemples représentatifs, la préparation des colonnes et l’évaluation restent nécessaires. Les tâches couvertes par RPT-1.5 et 1.6 sont la classification et la régression.
Trois limites doivent être distinguées, dont deux sont directement visées par les annonces de TechEd :
- Il ne s’agit pas d’un moteur spécialisé dans les séries temporelles : les caractéristiques temporelles doivent être préparées si le cas d’usage le requiert. C’est précisément le créneau du nouveau modèle RPT-TS (voir plus bas).
- L’entrée est une table unique : les jointures et l’assemblage de sources multiples doivent être effectués en amont. Le traitement natif de plusieurs tables est annoncé pour RPT-2, au premier trimestre 2027.
- Les sorties peuvent être contraintes, mais le modèle peut toujours produire une prédiction erronée ; cela ne constitue pas une garantie contre les « hallucinations ». Cette limite-là ne disparaîtra avec aucune version.
SAP-RPT 1.5 et 1.6 : quelle configuration choisir selon vos volumes de données ?
RPT-1.5 et RPT-1.5-large sont deux variantes du même modèle ; RPT-1.6 reprend le même découpage.
La récupération ciblée du contexte et Tabular Orchestration désignent un mécanisme complémentaire de sélection d’exemples, et non un troisième modèle.
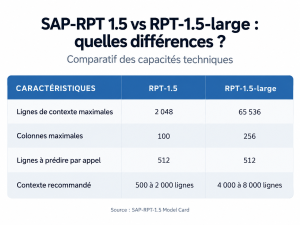 Ces valeurs proviennent de la model card SAP-RPT-1.5. Les plages recommandées sont un point de départ, pas une règle. La bonne taille de contexte se détermine sur le cas d’usage, avec une démarche simple : constituer un jeu de validation que le modèle n’a pas vu ; augmenter progressivement le nombre d’exemples fournis (500, 1 000, 2 000…) jusqu’à ce que le gain de qualité s’aplatisse ; vérifier à chaque palier que les catégories rares (un compte peu utilisé, un centre de coût marginal) restent correctement prédites, et que la latence et le coût par appel restent acceptables pour le volume quotidien visé. L’API du RPT Playground, ouverte à 1 000 requêtes par heure, permet de mener cette campagne en quelques heures, avant tout engagement de production.
RPT-1.6 pousse cette logique plus loin pour les grands historiques de données. La variante large accepte un contexte sensiblement plus grand et davantage de classes cibles, et introduit un mode « contexte profond » (deep context) réservé aux cas où plus de 8 000 lignes d’exemples sont nécessaires, au prix d’une latence et d’un coût supérieurs que SAP assume explicitement. Le chemin recommandé par SAP est gradué : commencer par RPT-1.6, passer à la variante large si la précision est insuffisante, n’activer le mode profond qu’en dernier recours.
Lorsque la table historique contient davantage de lignes que la fenêtre du modèle, Tabular Orchestration prend le relais. Ce service, dans le hub d’IA générative de SAP BTP, sépare ce que l’on configure une fois (la source de données, la description des colonnes, le scénario) de ce qui se passe à chaque appel : le service va chercher dans l’historique les exemples les plus proches des lignes à prédire, selon une stratégie aléatoire ou par similarité, puis les transmet au modèle. L’enregistrement d’une grande table de référence ne rend donc pas la fenêtre de contexte « illimitée » ; il automatise le choix des exemples. Deux lectures s’imposent pour une organisation SAP. D’abord, SAP reprend à son compte le problème le plus délicat de l’approche, « quels exemples envoyer ? », et promet que la configuration survivra aux changements de version et de modèle. Ensuite, l’historique doit résider dans le système de fichiers du data lake HANA Cloud : pour un client dont les factures vivent dans S/4HANA, c’est un prérequis d’intégration de données, pas un simple paramétrage.
Un sous-échantillonnage raisonné peut également suffire pour certains besoins, mais son efficacité dépend de la distribution des données, de la rareté des classes et du problème métier. Il ne faut pas généraliser qu’un échantillon de 1 000 à 2 000 lignes convient à tous les cas.
Comment expliquer et contrôler les prédictions de SAP-RPT ?
RPT-1.5 propose notamment une importance des colonnes et une attribution aux lignes du contexte : il devient possible de présenter des exemples historiques ayant contribué à une prédiction. Pour une facture affectée à un compte comptable, ces exemples peuvent faciliter la revue par un utilisateur métier.
Il ne faut toutefois pas confondre attribution statistique et justification métier. L’identification d’exemples influents ne démontre pas que la décision est conforme aux règles comptables ou réglementaires ; elle ne remplace pas non plus systématiquement les méthodes explicatives traditionnelles, comme SHAP.
SAP TechEd 2026 : quelles nouvelles capacités pour vos processus SAP ?
Les annonces du 27 octobre 2026 ne portent pas sur une nouvelle version de RPT-1 mais sur une extension du périmètre.
RPT-TS, disponible dès maintenant. Ce modèle de prévision de séries temporelles tourne nativement dans SAP HANA Cloud. On lui fournit un historique (ventes, demande, stocks, chiffre d’affaires) et il produit une prévision assortie d’intervalles de confiance, en gérant seules les valeurs manquantes, la saisonnalité et les séries multiples. SAP le positionne explicitement sur la prévision de la demande dans SAP Integrated Business Planning (IBP). Pour un planificateur, c’est l’équivalent d’une prévision statistique sans paramétrage de modèle ; pour une équipe data, c’est une alternative aux fonctions de séries temporelles déjà présentes dans la base (la bibliothèque PAL), à la différence qu’il n’y a rien à entraîner.
RPT-Decisions, prévu au quatrième trimestre 2026. C’est l’annonce qui touche le plus directement les utilisateurs métier. Le modèle vise à automatiser des décisions dans les processus : approuver une commande client dans S/4HANA, router une exception de supply chain dans IBP, choisir le circuit d’approbation d’une demande d’achat dans Ariba. Autrement dit, la prédiction n’est plus un indicateur posé dans un rapport, elle devient une action dans le workflow. Les questions à se poser avant TechEd étaient techniques (quelle précision, quel contexte) ; celles qu’ouvre RPT-Decisions sont de gouvernance : qui définit le seuil au-delà duquel la décision se prend sans validation humaine, comment la justifier en audit, et comment la révoquer. Les mécanismes de contrôle annoncés par SAP pour ses agents (journal d’audit, autorisations par rôle, points de validation humaine) s’appliqueront ; leur paramétrage reviendra aux clients.
RPT-2, prévu au premier trimestre 2027. La prochaine génération étend RPT-1.6 à trois capacités nouvelles. La détection d’anomalies et de valeurs aberrantes, avec l’exemple cité par SAP des écritures inhabituelles dans S/4HANA Finance : c’est le cas d’usage du contrôle interne et de l’audit, aujourd’hui couvert par des règles ou des outils tiers. Les « embeddings » de données structurées, c’est-à-dire la capacité à représenter chaque enregistrement par une empreinte numérique comparable aux autres, pour retrouver des enregistrements similaires (fournisseurs en doublon, réclamations comparables, pièces proches) sans écrire de règles. Et le traitement natif de plusieurs tables, qui lève la limite d’entrée unique évoquée plus haut, en permettant au modèle de lire directement l’en-tête de commande, ses postes et le fournisseur sans les aplatir au préalable.
La lecture d’ensemble. La conséquence pour un utilisateur SAP « classique » est que l’IA tabulaire arrivera directement dans ses outils (Joule, IBP, les approbations S/4HANA). La question n’est donc plus « faut-il adopter RPT ? » mais « comment valider et gouverner les prédictions que nos applications SAP vont produire ? ».
SAP-RPT ou machine learning classique : quelle approche privilégier pour votre SI ?
RPT constitue un candidat intéressant lorsqu’une organisation souhaite expérimenter différents cas de classification ou de régression, mais qui dispose de peu de données étiquetées ou doit prédire une cible comportant de nombreuses classes. Avec RPT-TS, la prévision de séries temporelles rejoint cette liste. L’existence d’un environnement SAP BTP ou HANA Cloud simplifie l’intégration.
Un modèle entraîné spécifiquement reste à comparer lorsque le cas d’usage est critique, que les contraintes de latence et de coût sont fortes, qu’une architecture temporelle spécialisée est nécessaire ou qu’un contrôle fin du modèle est imposé. Des données issues de plusieurs tables peuvent être exploitées dans les deux approches, à condition d’en préparer les variables, en attendant le multi-tables de RPT-2.
La démarche pratique consiste à définir une métrique métier, constituer un jeu de validation indépendant, tester RPT et au moins une référence classique, puis comparer précision, classes rares, latence, coût et contraintes de gouvernance. Une expérimentation rapide ne signifie pas une mise en production sans pipeline : la préparation, le contrôle et le suivi restent indispensables.
L’avis de notre expert : comment préparer votre organisation SAP à l’IA prédictive ?
William, Responsable Data & IA chez Business At Work, accompagne des organisations SAP sur leurs projets de données et d’intelligence artificielle.
« La vraie question qu’une organisation SAP doit se poser sur SAP-RPT n’est pas “ce modèle est-il meilleur que notre machine learning ?”, c’est “sommes-nous prêts à recevoir des prédictions dans nos processus SAP ?”. Jusqu’ici, l’IA tabulaire était un sujet de data scientists : on exportait des données de S/4HANA, on entraînait un modèle, on le déployait, on le maintenait. Avec SAP-RPT, une prédiction se teste en quelques heures sur ses propres factures, commandes ou nomenclatures, depuis SAP BTP ou directement en SQL dans SAP HANA Cloud, sans projet de machine learning. Le coût d’entrée a changé d’ordre de grandeur, et c’est ce qui rend le sujet accessible à une DSI SAP qui n’a jamais eu d’équipe data science.
Ce que SAP TechEd 2026 ajoute, c’est que ces prédictions ne resteront pas dans un bac à sable. Avec RPT-TS dans SAP IBP, RPT-Decisions dans les approbations S/4HANA et Ariba, et les agents Joule qui embarquent déjà le modèle, l’IA tabulaire arrive dans les outils du quotidien, Un contrôleur de gestion, un approvisionneur ou un comptable fournisseurs verra des propositions de compte, de prévision ou d’approbation générées par un modèle qu’il n’a pas choisi.
D’où notre recommandation : ne pas opposer SAP-RPT au machine learning classique, mais se doter d’une méthode avant que les prédictions n’arrivent. Des métriques métier par cas d’usage, un jeu de validation que le modèle n’a jamais vu, un seuil de qualité en dessous duquel l’humain reprend la main, et un circuit de gouvernance pour les décisions automatisées, auditables et révocables. L’effort ne disparaît pas : il se déplace de l’entraînement du modèle vers le cadrage, la qualité des exemples fournis et le contrôle des résultats. C’est précisément là que Business At Work intervient auprès de ses clients SAP : qualifier les cas d’usage où SAP-RPT apporte une valeur métier mesurable, mener l’évaluation comparative sur données réelles, et mettre en place la gouvernance qui permet de passer du prototype au processus. »
FAQ SAP-RPT : les réponses aux questions des DSI et responsables Data
<strong>SAP-RPT peut-il remplacer PAL et APL dans SAP HANA Cloud ?</strong>
<strong>Les données de notre entreprise sont-elles utilisées pour entraîner SAP-RPT ?</strong>
<strong>Peut-on utiliser SAP-RPT sans SAP BTP ?</strong>
<strong>Quels avantages RPT-TS apporte-t-il aux prévisions dans SAP IBP ?</strong>
<strong>Faut-il une équipe de data scientists pour déployer SAP-RPT ?</strong>
<strong>Quels cas d'usage SAP-RPT peut-il couvrir dans une entreprise ?</strong>
<strong>Comment évaluer SAP-RPT avant une mise en production ?</strong>